
W skrócie
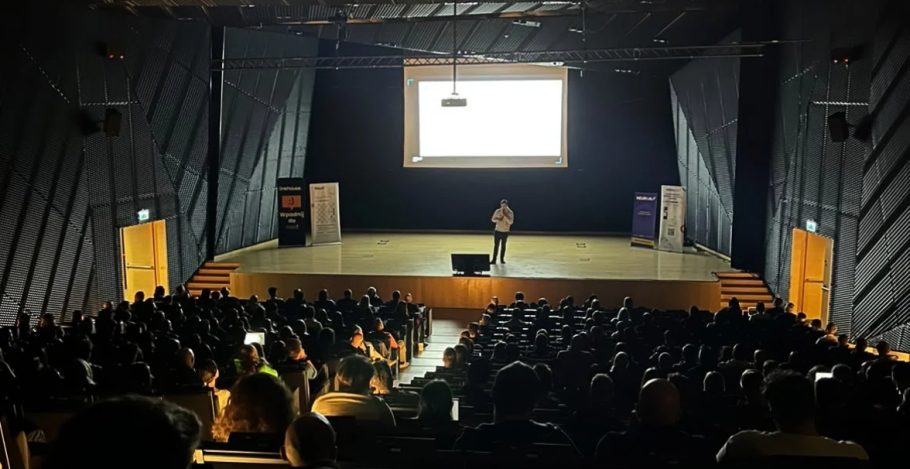
Festiwal SEO 2026, zorganizowany tradycyjnie w Międzynarodowym Centrum Kongresowym w Katowicach, skupił się na tym, co obecnie najbardziej rezonuje w naszej branży: zmianach wynikających z AI, technicznej analizie ogromnych zbiorów danych, a także przetasowaniach prawnych na linii Google vs Unia Europejska. Nie zabrakło też tematów fundamentalnych, takich jak optymalizacja treści (content pruning), ewolucja link buildingu czy procesy wdrażania audytów. Oceniamy tegoroczną edycję jako zderzenie świetnych, analitycznych case studies z kilkoma wystąpieniami, które niestety powielały znane już nam podstawy. Zobaczcie, co dokładnie z nich wynieśliśmy!
W tym artykule:
Daniel Bartosiewicz – „Jak napisać coś nowego, skoro wszystko w Internecie już było? (Sekret Information Gain)”
Prezentacja Daniela skupiła się na koncepcji Information Gain, czyli podbijaniu wartości treści poprzez dostarczanie do internetu nowych danych. W praktyce była to dość standardowa prelekcja przypominająca o tym, by szukać źródeł w miejscach rzadziej eksplorowanych – na przykład w niszowych publikacjach naukowych, które są rzadko cytowane, lub poprzez dobór tematów o celowo małym zainteresowaniu. Przydatne przypomnienie dla początkujących, choć dla doświadczonych SEO-wców szukających zaawansowanych technik inżynierii treści zabrakło tu większych rewelacji.
Daniel dorzucił też przykłady wiedzy wyniesionej z pracy w ubezpieczeniach i informacji, które pozostają ukryte za NDA. Wśród sposobów na Information Gain znalazły się własne badania, wywiady, case studies i proste narzędzia tworzone z pomocą AI. Dane można też wykorzystać ponownie w formie wykresu lub infografiki.
Kris Flank – „Jak przestać marnować pieniądze na budowanie linków (co naprawdę działa w 2026 r.)”
Anglojęzyczna prelekcja Krisa dotknęła newralgicznego punktu – przepalania budżetów na bezwartościowe linki. Autor skupił się na tym, co faktycznie daje teraz mierzalny ROI, udowadniając m.in. dlaczego według niego precyzyjne link insertions często dają lepsze efekty biznesowe niż klasyczne, masowe i drogie guest posty. Duży nacisk położono również na pozyskiwanie autentycznych wzmianek o marce (brand mentions) jako sygnału zaufania, co ma kluczowe znaczenie w budowaniu autorytetu dla modeli LLM i AI Overviews.
Kris pokazał przykład linku za 50 dolarów z serwisu niemal pozbawionego ruchu i żartobliwie przeliczał budżet na Negroni. Przy wyborze miejsca publikacji zalecał sprawdzić stabilność ruchu i perspektywę serwisu za rok. A przy link insertion poprawić cały akapit, żeby odnośnik naturalnie wynikał z jego treści.
Paweł Sokołowski – „Audyt Marki w AI. Jak maszyny rozumieją nasz przekaz?”
Wystąpienie Pawła dotyczyło weryfikacji tego, jak systemy sztucznej inteligencji czytają naszą markę i ofertę (np. czy kluczowe informacje nie giną zablokowane przez złożony JavaScript). Mimo dobrego tytułu, ostatecznie sprowadziło się to do pewnych oczywistości o tym, jak AI widzi i prezentuje brand w sieci, utwierdzając nas jedynie w przekonaniu, że absolutną podstawą obecności w AI jest po prostu ułatwienie botom dostępu do informacji na samej stronie.
Konkretnym przykładem był audyt CONTADU: różne podstrony podawały inną długość okresu próbnego, a część szczegółów cennika była zależna od JavaScriptu. Pojawił się też scenariusz, w którym firma wycofuje darmowy plan, lecz model nadal go poleca. Techniczny dostęp do strony i aktualność wiedzy o ofercie to więc dwa osobne elementy do sprawdzenia.
Wojciech Urban – „Co AI naprawdę robi z wyszukiwaniem – wnioski z 33 mln fraz z Search Console”
Zdecydowanie jeden z najmocniejszych merytorycznie punktów Festiwalu! Wojtek przetrawił potężną paczkę danych z GSC (ponad 1,2 miliarda wierszy), by sprawdzić tezę o zmianie zachowań użytkowników. Wnioski? Bardzo rozbudowana analiza udowodniła, że ludzie wcale nie rzucili się do wpisywania długich, skomplikowanych promptów bezpośrednio w okno wyszukiwarki – takich zapytań jest na razie bardzo mało. Wojtek zaprezentował też zgrabny test radzenia sobie ze zanonimizowanymi zapytaniami. Dodatkowo zwrócił uwagę, by przy analizach oddzielać ruch mobilny, gdyż ten desktopowy bywa mocniej zaburzony przez wszelkiego rodzaju zautomatyzowane zapytania i artefakty. Jak się okazuje, również zapytania typowo brandowe domagają się obecnie zupełnie odrębnej analityki. Kawał dobrej analitycznej roboty.
Na slajdach skalę badania opisano jako 974 usługi GSC, ponad 33 mln unikalnych fraz i 10,3 mld wyświetleń z 20 miesięcy. Ciekawy był rozmiar luki w danych: zapytania były niewidoczne przy 38–52% wyświetleń i 36–42% kliknięć. Wśród pozornych „promptów” pojawiały się również wklejone zadania z podręczników.
Paulina Iciek – „Bestiariusz wdrożeń SEO. Jak pokonać potwory, które stoją między audytem a wdrożeniem”
Problem tak stary jak samo pozycjonowanie: audyt leży w szufladzie, a deweloperzy robią swoje. Paulina omówiła temat oporu wobec wdrożeń SEO, utrzymując całą prezentację w mocnym, wiedźmińskim klimacie (było sporo nawiązań i wstawek ze świata Sapkowskiego/CD Projekt Red). Pomimo świetnej oprawy audiowizualnej, pod kątem wiedzy była to prelekcja pełna znanych i dość oczywistych rad dotyczących m.in. komunikacji na linii SEO-Dev czy umiejętnej priorytetyzacji. Trudno jednak nie przyznać racji ogólnemu stwierdzeniu, że rzetelnie i zrozumiale sformułowany bilet zadań (ticket) potrafi uciąć zbędne dyskusje i zaoszczędzić czas.
Wśród konkretów znalazły się trzy najważniejsze wdrożenia w mailu z audytem, lista z podziałem zadań oraz opis stanu przed zmianą i po niej w ticketach. Paulina proponowała też przejrzeć kolejkę developerską: czasem rekomendację SEO można dołączyć do zadania, które już w niej czeka.
Mateusz Jarominiak – „Google vs UE. Jak DMA zmienia wyniki wyszukiwania i SEO”
To była niezwykle ciekawa i rzucająca świeże spojrzenie na rynek prelekcja. Mateusz na przykładzie porównywarki Ceneo rozebrał na czynniki pierwsze to, jak Google poprzez wprowadzanie własnych modułów (porównywarek cen czy lotów) spychało organiczne wyniki i konkurentów głęboko w dół SERP-ów, dopuszczając się de facto nieuczciwych praktyk rynkowych. Poznaliśmy kulisy wprowadzania unijnych przepisów DMA (Digital Markets Act) i dowiedzieliśmy się, jak rynkowi giganci walczą o odzyskanie sprawiedliwego interfejsu wyszukiwarki. Świetnie pokazało to, że nowoczesne SEO to nie tylko technika, ale też uwarunkowania legislacyjne.
Mateusz porównywał układ wyników przed kolejnymi zmianami związanymi z DMA i po nich, a także rynek unijny z Wielką Brytanią. Przypominał, że przy tej samej pozycji organicznej CTR może się zmienić wraz z otaczającymi wynik modułami. Zalecał archiwizować screenshoty SERP-ów, dane o ruchu i korespondencję.
Kamil Brzozowski – „Content pruning – dlaczego jest kluczowym narzędziem w czasach nadpodaży treści”
Świetne wystąpienie oparte na mierzalnych danych. Kamil rozłożył na czynniki pierwsze jedno potężne case study z bardzo agresywnym content pruningiem. Akcja polegała na wycięciu kilkuset tekstów po uprzedniej, rygorystycznej analizie, mającej udowodnić, które treści kompletnie nie generują ruchu i obciążają serwis. Co najważniejsze: efekt tego radykalnego „cięcia” zaowocował tym, że parametry i ruch na domenie nie tylko nie spadły, ale wręcz urosły! Doskonały dowód na to, że higiena i optymalizacja własnych zasobów bywa ważniejsza niż ciągła, ślepa produkcja nowych tekstów.
W przypadku AuraHerbals.pl usunięto 249 artykułów, czyli 43% sekcji poradnikowej, odpowiadających za 0,8% jej kliknięć. Dalsze prace objęły przepisanie 89 artykułów leksykonu i dodanie 68 tekstów w silosie probiotyków, więc pokazany wzrost dotyczył szerszego procesu. Dodatkowym smaczkiem był „wskaźnik starości”: 75. percentyl wieku wyników TOP10, liczony osobno dla danego tematu.
Aleksandra Kołodziejska – „SEO content, który kochają boty, użytkownicy, a nawet copywriterzy”
Zapowiedzi obiecywały inżynierię treści z odrzuceniem archaicznego „keyword stuffingu”, ale w praktyce dostaliśmy dosyć standardową prelekcję. Całość skupiła się na znanych od lat fundamentach: jak pisać angażujące i czytelne teksty, zachowując zbalansowaną architekturę informacji. Z punktu widzenia doświadczonego specjalisty technicznego SEO – niestety nic odkrywczego.
Jedna z praktycznych wskazówek dotyczyła odpowiedzi bezpośrednio pod nagłówkiem. Ważny warunek lub wyjątek powinien znajdować się obok, żeby fragment zachował sens po wyjęciu z artykułu. Aleksandra rozróżniała też samo znalezienie URL-a przez system AI od faktycznego odczytania strony oraz szerokie pokrycie tematu od udzielenia konkretnej odpowiedzi.
Marcin Żmuda – „Czy miłość może być encją?”
Zdecydowanie najdziwniejsza prezentacja podczas tegorocznej edycji. Marcin zaserwował nam rozważania o tym, w jaki sposób roboty wyszukiwarki starają się kategoryzować pojęcia abstrakcyjne (takie jak tytułowa miłość), które przecież nie posiadają daty założenia, NIP-u czy adresu. Wnioskiem autora było to, że Google może rozpoznawać takie pojęcia dzięki ich znaczeniu, relacjom i kontekstowi. Prelekcja przypominała raczej wystąpienie z konferencji filozoficznej i zostawiła nas z poczuciem sporego niedosytu twardych danych.
Na przykładzie miłości Marcin rozdzielił trzy intencje: zrozumienie pojęcia, szukanie sposobów pielęgnowania relacji i znalezienie gotowych życzeń. Każda prowadzi do innego tekstu. Pokazał też piramidę treści opartą na pytaniach: o czym piszemy, co konkretnie chcemy powiedzieć i skąd to wiemy. We wstępie pojawił się nawet opatentowany przez Google gest serca z dłoni.
Mateusz Godzic – „Weź to oblicz! – Case study z Site Focus i Site Radius”
Na koniec prawdziwa techniczna perełka. Mateusz zabrał nas w mocno zmatematyzowaną podróż po kumulacji tematycznej serwisów. Poznaliśmy proces tworzenia wskaźników Site Focus (skupienie tematyczne) i Site Radius (rozproszenie tematyki). Świetnie opowiedziane case study ze wszystkimi anegdotami o ślepych zaułkach i błędach wyliczeniowych w początkowych fazach projektu. Docelowo prelekcja płynnie promowała nową funkcjonalność w narzędziu WhitePress, jednak imponował fakt, jak to nieszablonowe wykorzystanie wektorów (embeddings) pozwala obecnie wręcz błyskawicznie przetwarzać gigantyczne zbiory danych.
Jedną z pułapek był wynik 0,95 uzyskany ze śmieciowych danych. Mateusz pokazywał więc, po co potrzebne są kalibracja i kontrola jakości wejścia. W analizie 26 mln URL-i trafiał m.in. na nagłówki „MENU” i „czytaj więcej”. Na mapie treści wskazał też 62 strony dalekie od centrum i z małą liczbą kliknięć jako kandydatów do przeglądu.
Podsumowanie
Tegoroczny Festiwal SEO 2026 pokazał, że branża dzieli się dziś wyraźnie na dwa fronty. Z jednej strony mamy tych, którzy wciąż tłumaczą, jak pisać teksty i poprawiać wdrożenia, z drugiej – specjalistów sięgających po zaawansowaną analitykę i analizę wielkich zbiorów danych (Urban, Godzic, Brzozowski) czy badających legislacyjno-monopolistyczne tło działania Google’a (Jarominiak). Dla nas – jako zespołu lubiącego twarde, analityczne SEO – to właśnie prelekcje z tej drugiej grupy udowodniły, że warto było spędzić ten dzień w Katowicach. Wielkie podziękowania dla organizatorów i do zobaczenia za rok!
Po artykule

 (1 głosów, średnia: 5,00 / 5)
 Loading...
Pogłębij wiedzę z Marketing
User Experience (UX) i CRO w e-commerce – jak poprawić konwersję dzięki UX
Sklepy e-commerce konkurują ze sobą o uwagę klienta nie tylko reklamą, asortymentem, czy cenami. Równie ważnym czynnikiem, który wpływa na zakupy (ich wielkość i...

Growth hacking, co to jest i jak to działa?
 7 minut czytania