

W skrócie
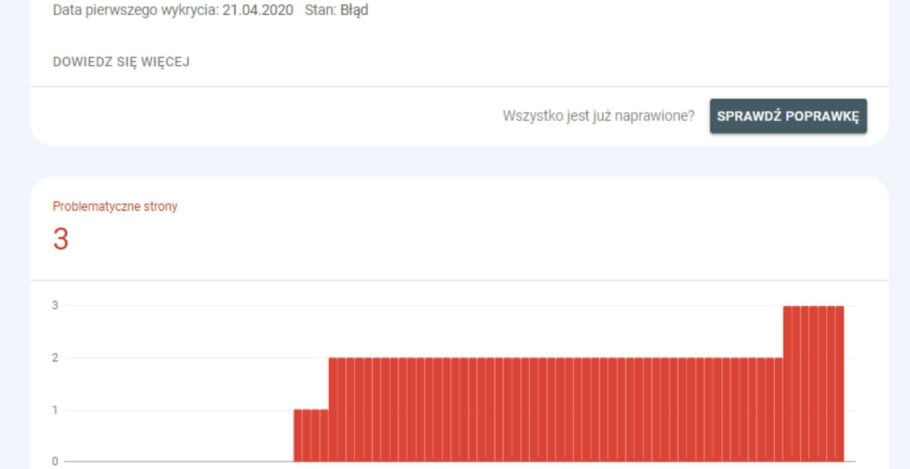
Komunikat o błędzie “przesłany URL jest zablokowany przez plik robots.txt” oznacza, że strona nie może być zaindeksowana z powodu sprzecznych dyrektyw. Weryfikacja i aktualizacja pliku robots.txt są kluczowe dla rozwiązania tego problemu. W przypadku braku dostępu do pliku, należy skontaktować się z usługodawcą w celu dokonania niezbędnych zmian.
W tym artykule:
Adres zablokowany przez robots.txt
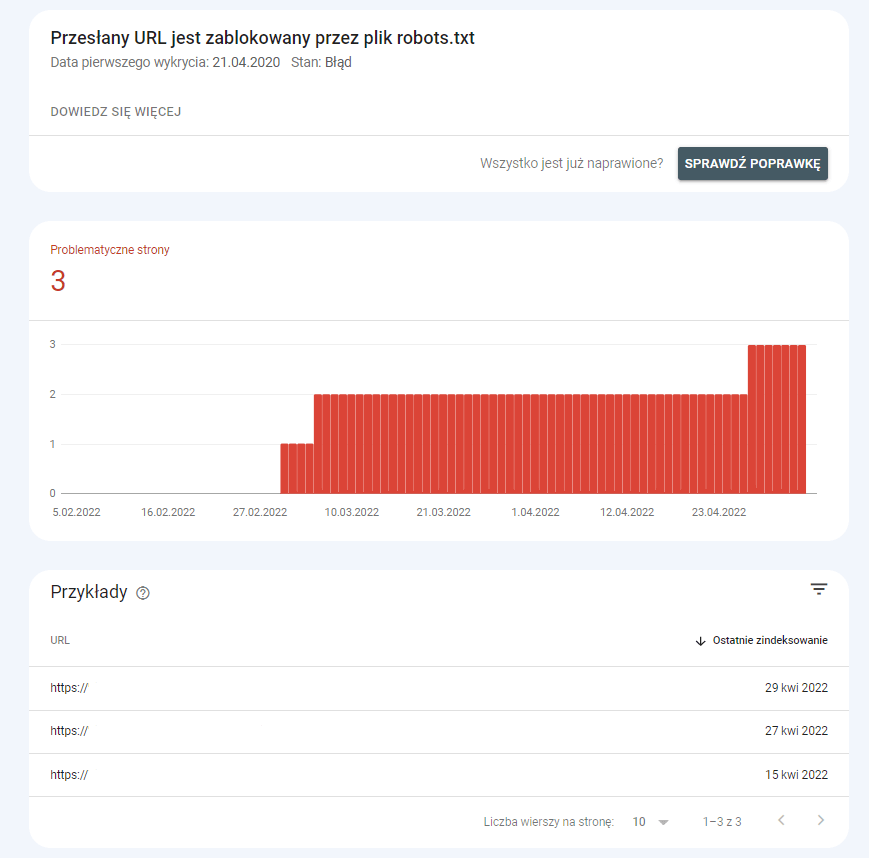
Komunikat, że “przesłany URL jest zablokowany przez plik robots.txt” oznacza, że strona, która została przesłana do zaindeksowania jest jednocześnie zablokowana w pliku robots.txt, co uniemożliwia indeksację. Powoduje to powstanie błędu, ponieważ prośba i dyrektywa wzajemnie się wykluczają.
Jak naprawić ten błąd?
Pierwszym krokiem w naprawie błędu jest zweryfikowanie pliku robots.txt. Można to zrobić np. testerem dostarczanym przez Google, które od razu wskaże element, który powoduje blokowanie indeksacji. W tym celu wystarczy rozwinąć panel boczny, w którym znajdują się narzędzia i wybrać opcję “Przetestuj blokowanie przez plik robots.txt”. Wówczas od razu sprawdzimy interesujący nas adres.
Znajdź bariery, które hamują Twój wzrost
Kolejnym krokiem jest aktualizacja samego pliku robots.txt. Można go pobrać na kilka sposobów np. bezpośrednio ze strony, za pomocą dedykowanego narzędzia lub z Google Search Console. Po pobraniu i poprawieniu (lub usunięciu) elementu, który powodował błąd, wystarczy wgrać plik z powrotem do katalogu głównego strony. Proces wgrywania będzie różnił w zależności od wykorzystywanego oprogramowania i dostawcy usług hostingowych.
Naprawa może się skomplikować, gdy nie ma się dostępu lub uprawnień do edytowania pliku robots.txt. Wówczas trzeba skontaktować się z usługodawcą, poinformować o problemie i poprosić o poprawę.
Może się jednak zdarzyć, że strona została zablokowana w pliku robots.txt celowo, aby nie indeksowała się w Google. Wówczas należy sprawdzić mapę witryny, ponieważ strona mogła zostać w niej umieszczona automatycznie – np. na skutek działania skryptu generującego mapę z wszystkich istniejących adresów URL. Jeżeli tak się stało, aktualizujemy mapę witryny (czyli tzw. sitemapę). W takiej sytuacji należy również zadbać, aby ta strona oraz inne, które nie mają się indeksować, nie trafiały do mapy.
Więcej informacji: https://support.google.com/webmasters/answer/7440203?hl=pl#
O innych błędach w GSC pisaliśmy tutaj:
Po artykule
 (3 głosów, średnia: 5,00 / 5)
 Loading...
Pogłębij wiedzę z SEO
SEO co to jest optymalizacja i pozycjonowanie stron? (search engine optimization)
Od pewnego czasu zastanawiasz się nad pozycjonowaniem swojej strony internetowej, jednak nie masz pewności, czym dokładnie jest SEO? Zależy Ci na tym, aby Twoja...

Przerwa na SEO#01: Czym jest SEO (i czym nie jest)?
 6 minut czytania