

W skrócie
Komunikat o tym, że strona została zaindeksowana, ale zablokowana przez plik robots.txt, wskazuje na to, że mimo ograniczeń w pliku, roboty Google mogły znaleźć link do niej w internecie. Aby naprawić ten problem, należy dodać dyrektywę “noindex” w metatagu lub nagłówku HTTP oraz zaktualizować plik robots.txt, usuwając z niego ograniczenia dotyczące indeksowania.
W tym artykule:
Strona zindeksowana, ale zablokowana przez plik robots.txt
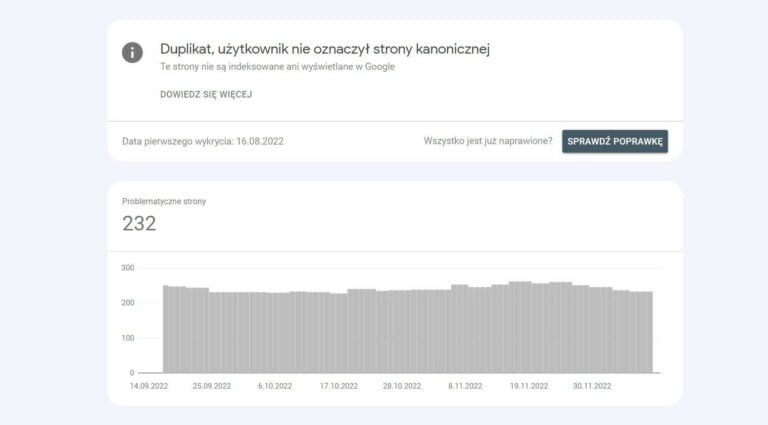
Komunikat, że strona została zindeksowana, ale zablokowana przez plik robots.txt oznacza, że pomimo ograniczenia indeksowania strony w pliku robots.txt i tak została zaindeksowana przez wyszukiwarkę Google.
Powodem takiego stanu rzeczy może być fakt, że roboty Google znalazły link do danej strony, ponieważ ktoś poza właścicielem czy administratorem utworzył go do niej gdzieś w internecie. Zawartość pliku robots.txt nie stanowi bowiem jednoznacznego “zakazu” indeksacji, a jest jedynie sugestią dla robotów wyszukiwarek. Wówczas w wyszukiwarce ta strona może pojawić się z ograniczoną zawartością czy zupełnie bez zawartości.
Znajdź bariery, które hamują Twój wzrost
Jak naprawić ten problem?
W tej sytuacji są dwa rozwiązania problemu, które zależą od tego czy strona ma się pojawiać w wynikach wyszukiwania czy nie.
Jeżeli strona, zgodnie z pierwotnym założeniem, ma być zablokowana, należy umieścić dyrektywę “noindex” w metatagu w jej kodzie lub w nagłówku HTTP. Kolejny krok to aktualizacja robots.txt, który można pobrać bezpośrednio ze strony, za pomocą dedykowanych narzędzi czy z Google Search Console. Należy z niego usunąć informacje o ograniczeniu indeksowania i wgrać plik z powrotem do katalogu głównego witryny. Proces wprowadzania zmian będzie się różnił w zależności od używanego systemu CMS i hostingu.
Ten sam proces usuwania blokady indeksacji z robots.txt należy przejść, gdy strona ma się jednak indeksować. Wówczas po usunięciu ograniczenia strona powinna zostać zeskanowana i pojawiać się w wyszukiwarce w całości.
Gdy błąd zostanie naprawiony, niezależnie od wybranej opcji, w raporcie należy wybrać “Sprawdź poprawkę”. Oczekiwanie na wyniki może potrwać nawet do kilkudziesięciu dni.
O innych błędach w GSC pisaliśmy tutaj:
- Co to jest błąd przekierowania i jak go naprawić?
- Co to jest błąd serwera (5xx) i jak go naprawić?
- Co oznacza, że przesłany URL jest zablokowany przez plik robots.txt?
- Co oznacza, że przesłany URL zawiera tag „noindex”?
- Czym jest pozorny błąd 404 i jak można go naprawić?
- Co to jest błąd 401 i jak go naprawić?
- Co to jest błąd 403 i jak go naprawić?
- Co oznacza, że przesłany URL jest zablokowany z powodu innego błędu 4xx?
Po artykule


 (3 głosów, średnia: 3,67 / 5)
 Loading...
Pogłębij wiedzę z SEO
SEO co to jest optymalizacja i pozycjonowanie stron? (search engine optimization)
Od pewnego czasu zastanawiasz się nad pozycjonowaniem swojej strony internetowej, jednak nie masz pewności, czym dokładnie jest SEO? Zależy Ci na tym, aby Twoja...

Przerwa na SEO#01: Czym jest SEO (i czym nie jest)?
 5 minut czytania